就在刚刚,Anthropic 首次详细公开了 Claude 参与研发下一代 AI 的内部进度。
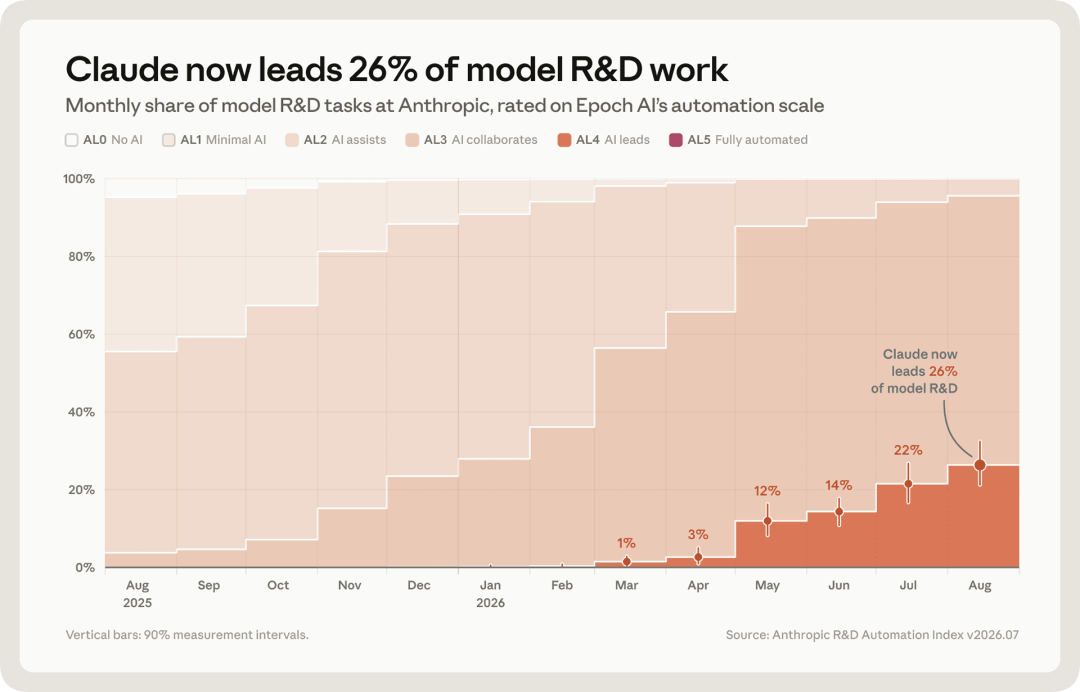
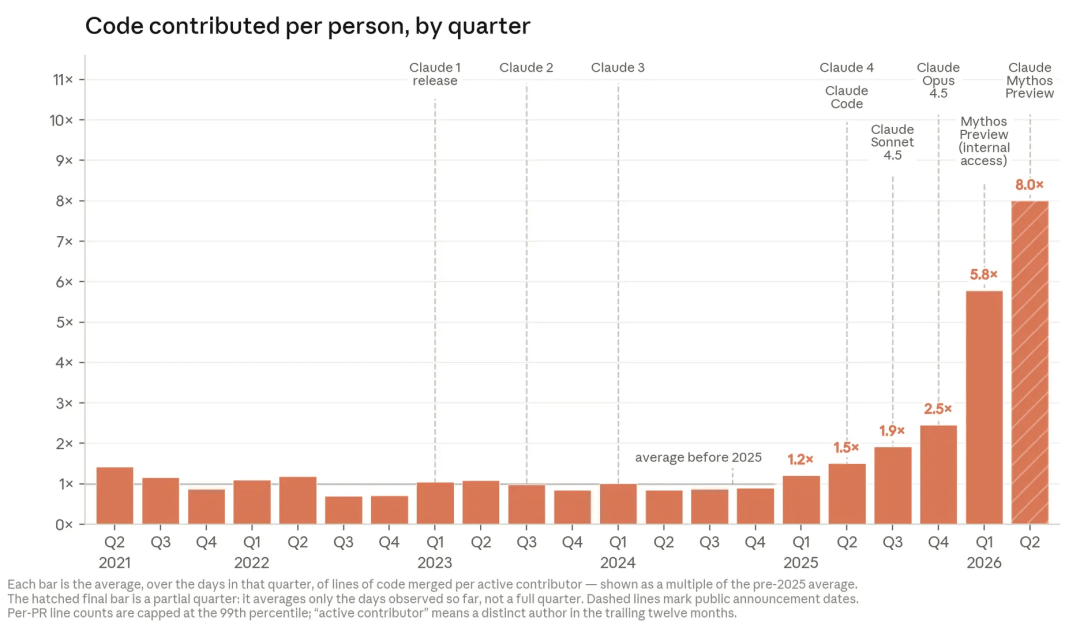
截至今年 8 月,Claude 已经能够「主导」Anthropic 约 26% 的 AI 研发工作,超过 90% 的任务至少达到「AI 协作」水平。对比之下,今年 2 月,Claude 能够主导的工作占比还不到 1%。
与此同时,大约有 3 万个 AI Agent 正在 Anthropic 最常用的内部平台上从事研究和工程工作。
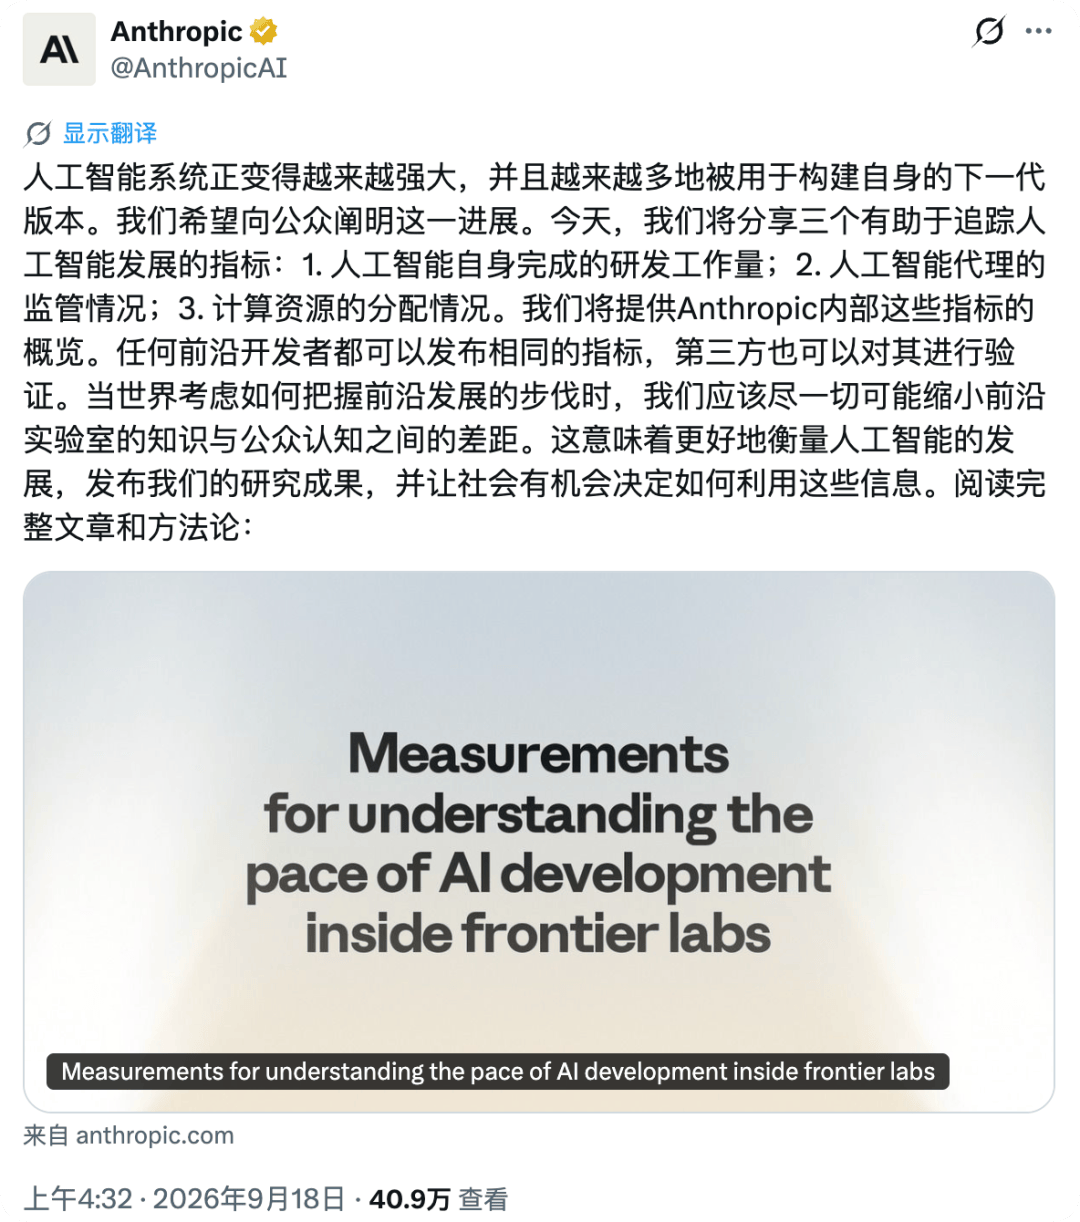
仅在今年 8 月,它们就作出了超过 10 亿次决策,其中约 0.002% 被实时监控系统拦截,相当于每 4.7 万次触发一次阻止机制。
此外,Anthropic 还披露,用于 AI 研发的算力中约有 6% 流向安全研究,在 AI 驱动的 AI 研发算力中,这一比例为 12%。
那么问题来了,当 AI 开始参与制造下一代 AI,人类是否还能看清它的速度,并及时干预它的行动。
AI 造 AI,已经进入 Anthropic 的研发现场
为了测量 Claude 对内部研发工作的参与程度,Anthropic 建立了一套名为「Anthropic 研发自动化指数」的原型系统。
该指数采用 Epoch AI 提出的自动化等级,将 AI 参与研发的程度划分为 AL0 至 AL5 六个级别。
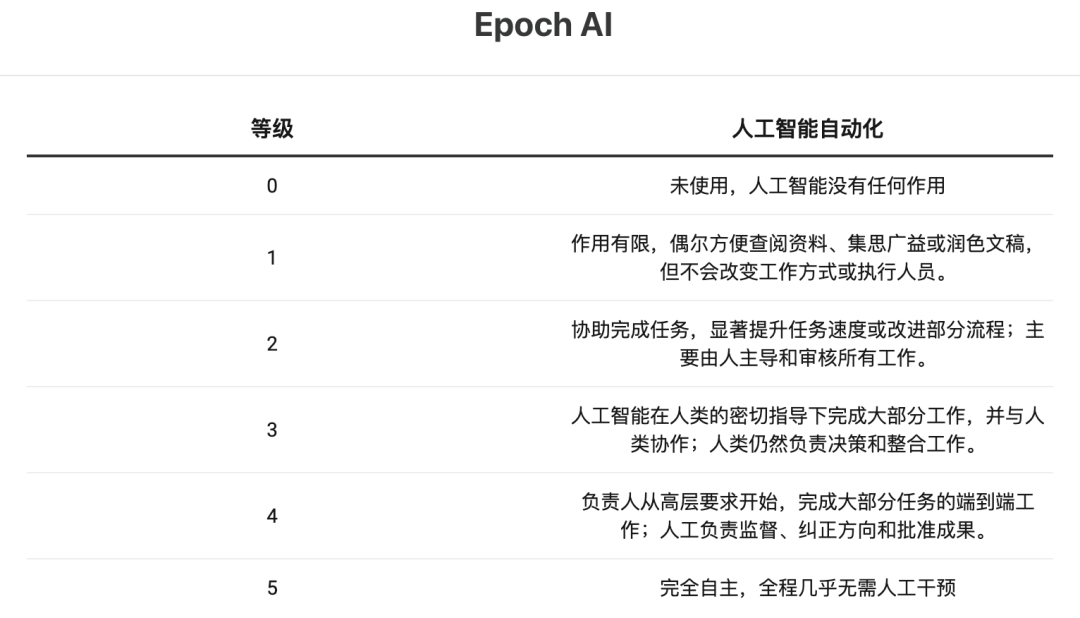
AL0 代表没有 AI 参与,AL3 代表 AI 可以在工程师密切指导下承担大量工作,AL4 代表 AI 接到一个高层目标后,可以完成大部分任务,只在关键节点接受人类监督。AL5 则意味着 AI 能够发现问题、规划任务、执行修改、完成测试并直接部署,全程无需人类介入。
Anthropic 所说的「Claude 主导 26% 的 AI 研发工作」,对应的是 AL4。
以一条夜间数据管道发生故障为例,在 AL3 阶段,工程师需要查看日志、提出初步判断,并在 Claude 遇到新问题时继续提供指导。进入 AL4 后,工程师只需把故障提醒交给 Claude,后者便可以自行分析日志、寻找故障环节、编写和测试修复方案、处理过程中出现的意外情况,并在测试数据上重新运行管道。
完成上述工作后,Claude 会整理问题原因和修改内容,再由工程师决定是否部署。人类依然掌握最终发布权,但已经不需要持续参与整个处理过程。
不过,截至今年 8 月,Anthropic 尚未发现任何一类 AI 研发工作达到 AL5。
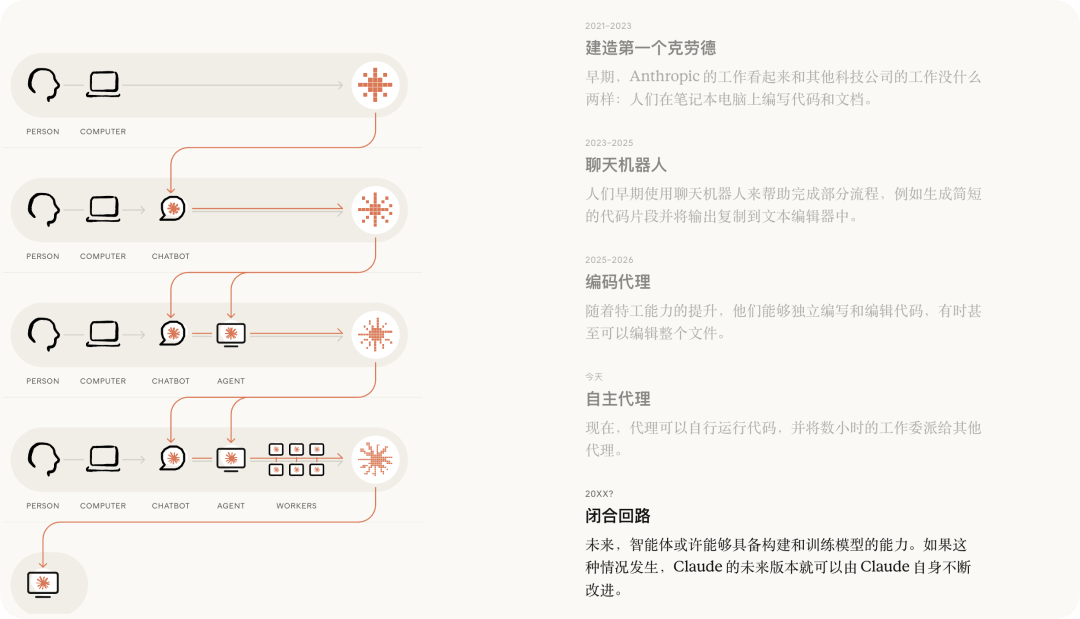
Claude 还不能自主监控所有故障,也不能在无人审批的情况下将修改部署到生产环境。Claude 并未实现递归自我改进,但 AI 参与开发下一代 AI 的工程循环,已经从研究设想进入可统计、可追踪的内部生产流程。
为了建立这套指数,Anthropic 在今年 7 月每周随机抽取相关部门约 20% 的员工,让 Claude 研究这些员工在 Slack 和内部文档中留下的工作记录,最终整理出约 1.5 万项具体研发任务。
随后,Claude 又将这些任务组织成一棵包含 542 个节点的层级树,其中包括 378 个具体任务类别,覆盖预训练、强化学习、评测平台故障、沙盒网络策略和推理服务事故复盘等工作。Anthropic 再按照员工投入的工作时间分配权重,判断不同任务在整体研发流程中的重要程度。
从数据变化来看,Claude 能够主导的研发工作占比已经从今年 2 月的不足 1%,上升至 8 月的 26%。短短半年内,AI 在 Anthropic 内部的身份开始从研发工具转向能够接手完整任务的研发参与者。
当 3 万个 Agent 开始替人类做决定
研发自动化程度上升之后,Anthropic 面临的另一个问题随之浮现。当数万个 Agent 同时运行,并且可以长时间执行任务、相互分配工作时,传统依靠人工逐项审查的管理方式已经难以覆盖所有行为。
截至 2026 年 8 月,在 Anthropic 使用最频繁的内部平台上,大约有 3 万个 Agent 同时从事研究和工程工作。为了监控它们,Anthropic 部署了实时监控和事后监控两套系统。
实时监控会在 Agent 执行动作前检查相关行为,重点阻止可能迅速造成严重后果的操作,例如将模型权重复制到外部系统。Anthropic 表示,该平台上所有 Agent 的操作都会经过实时监控,检查通常在几秒内完成,被拦截的行为会在一周内接受人工复查。
今年 8 月,Anthropic 的研究和工程 Agent 总共作出了超过 10 亿次决策,其中约 0.002% 被实时监控系统阻止,比例约为每 4.7 万次一次。
事后监控系统则会读取 Agent 已经完成的活动,用于发现发展较慢、仍有机会逆转的风险,例如可能与模型失准有关的行为。系统每周会标记大约 10 万份对话记录,多层分类器负责排除误报并进行初步筛选,最后约有 50 份最高优先级记录提交给人类审查。
按照 Anthropic 披露的数据,事后监控系统每 1000 份记录会标记一至两份。单个 Agent 出现异常行为的概率并不高,但当 Agent 的运行规模从数万扩大至数百万甚至数十亿时,低概率事件也可能频繁发生。
Anthropic 还为内部 Agent 设置了独立身份,每个 Agent 产生的数据、发送的消息和执行的动作都与身份绑定。即使底层模型升级,Agent 的历史记录仍会保留。不同 Agent 通过共享消息系统交流,其他 Agent 可以检查它发布的信息、查看原始引用,并在发现错误时进行纠正。
相关设计让 Anthropic 可以沿着身份和通信记录追踪每一次操作,但公司也承认,现有监控系统只运行了几个月,目前仍无法确认是否已经覆盖所有潜在行为模式。
安全研究,只拿到了 6% 的研发算力
除了研发自动化和 Agent 监控,Anthropic 还首次公开了内部算力的分配情况。
公司统计了 2026 年 7 月 13 日至 7 月 20 日的全部算力使用记录,并将相关工作划分为 AI 研发和安全研究等类别。结果显示,在分配给 AI 研发的算力中, 约有 6% 用于安全工作;在 AI 驱动的 AI 研发算力中,安全工作的占比约为 12%。
Anthropic 将安全工作定义为主要目标在于提高模型安全性、可理解性和系统安全性的研究,包括对模型思维过程进行审计、研究失准行为以及评估模型能否安全部署。训练生产模型、产品开发、能力研究和开发者工具等工作都被计算在其他 AI 研发中。
如果一项工作同时提升模型能力和安全性,Anthropic 会将其归入能力研发,因此公司认为 6% 和 12% 都属于相对保守的估算。用于安全分类器的算力也没有计入其中,而该部分的规模据称与公开数字大致相当。
统计过程中,Claude 分类器读取了训练任务的元数据和相关代码,并判断每项工作属于安全研究还是其他研发。在接近 1 万次研究训练与评测任务中,Anthropic 抽样检查了约 14%,同时提高高算力任务的抽样权重,以便数据更接近真实的算力流向。
谁来监督那些负责制造 AI 的 AI
Anthropic 公布这些数据的背景,是前沿 AI 的发展速度正在引发越来越多争议。公司 CEO Dario Amodei 此前公开呼吁放慢前沿 AI 的推进节奏,希望行业建立更明确的透明机制和安全要求。
按照 Anthropic 的计划,公司将邀请来自多个机构的独立评估人员进入内部系统,为其提供接近风险评估团队的流程、系统和数据访问权限。这些第三方将检查安全措施、报告相关事件,并持续追踪研发自动化、Agent 监控和算力分配等指标。
Anthropic 也承认,目前的数据仍然存在明显局限。研发自动化指数由 Claude 收集材料并进行判断,相当于让公司的模型评估自己参与的工作。不同实验室尚未采用统一方法,因此这些数字暂时无法直接用于横向比较。
在内部验证中,Claude 与人类对自动化等级的判断完全一致率为 59%,两名人类评估者之间的完全一致率只有 35%。 如果允许一个等级的误差,Claude 与人类判断的一致率可以达到 97%,但「AI 协作」和「AI 主导」之间依然存在较大的解释空间。
Anthropic 目前也采用固定的任务目录衡量自动化程度,这种方法能够看出原有人类工作被 AI 接管了多少,却可能遗漏随着技术发展产生的新任务。Agent 监控数据只覆盖公司最常用的一套内部平台,算力统计也只有一周,因此所有指标仍需要持续更新和独立验证。
即便带着这些限制,Anthropic 披露的数据仍然提供了一张罕见的前沿实验室内部预览图。
当一家 AI 公司开始用数万个 Agent 研发 AI,再用另一批 AI 监控和评价这些 Agent 时,递归自我改进依然没有真正到来,可供它生长的早期循环已经出现在现实的研发系统中。
官方博客🔗
https://www.anthropic.com/institute/measuring-pace-of-ai-development
本文来自转载APAP ,观点仅代表作者本人,发现AI平台仅提供信息存储空间服务。
如若转载,请联系原作者;如有侵权,请联系编辑删除。

 微信扫一扫