去年,扎克伯格挥舞支票满世界招揽 AI 人才,部分薪酬方案高达上亿美元,手笔之大,堪比 NBA 球星转会。如今,高价组建的团队终于交出了一份更接近预期的成绩单。
就在刚刚,Meta 发布新模型 Muse Wonder 系列模型(内部代号西瓜),包括 Muse Wonder 和 Muse Wonder Full,主攻个人与专业智能体任务,重点提升跨对话记忆、长时间执行任务和编程能力。
扎克伯格在接受采访时表示,Meta 已经抵达 AI 技术的最前沿。
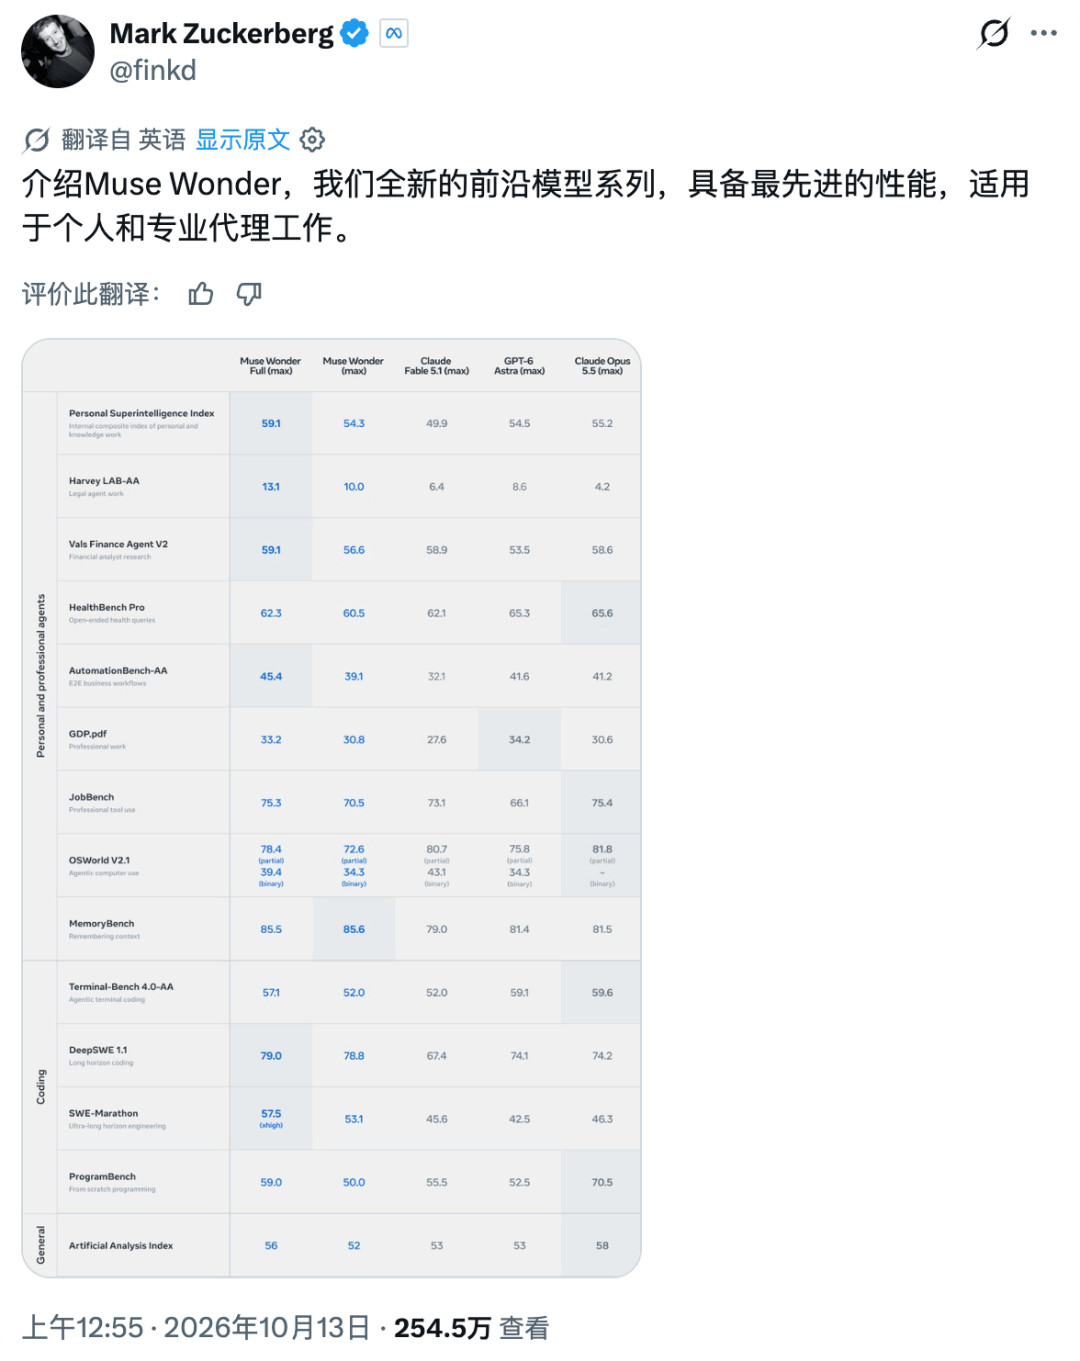
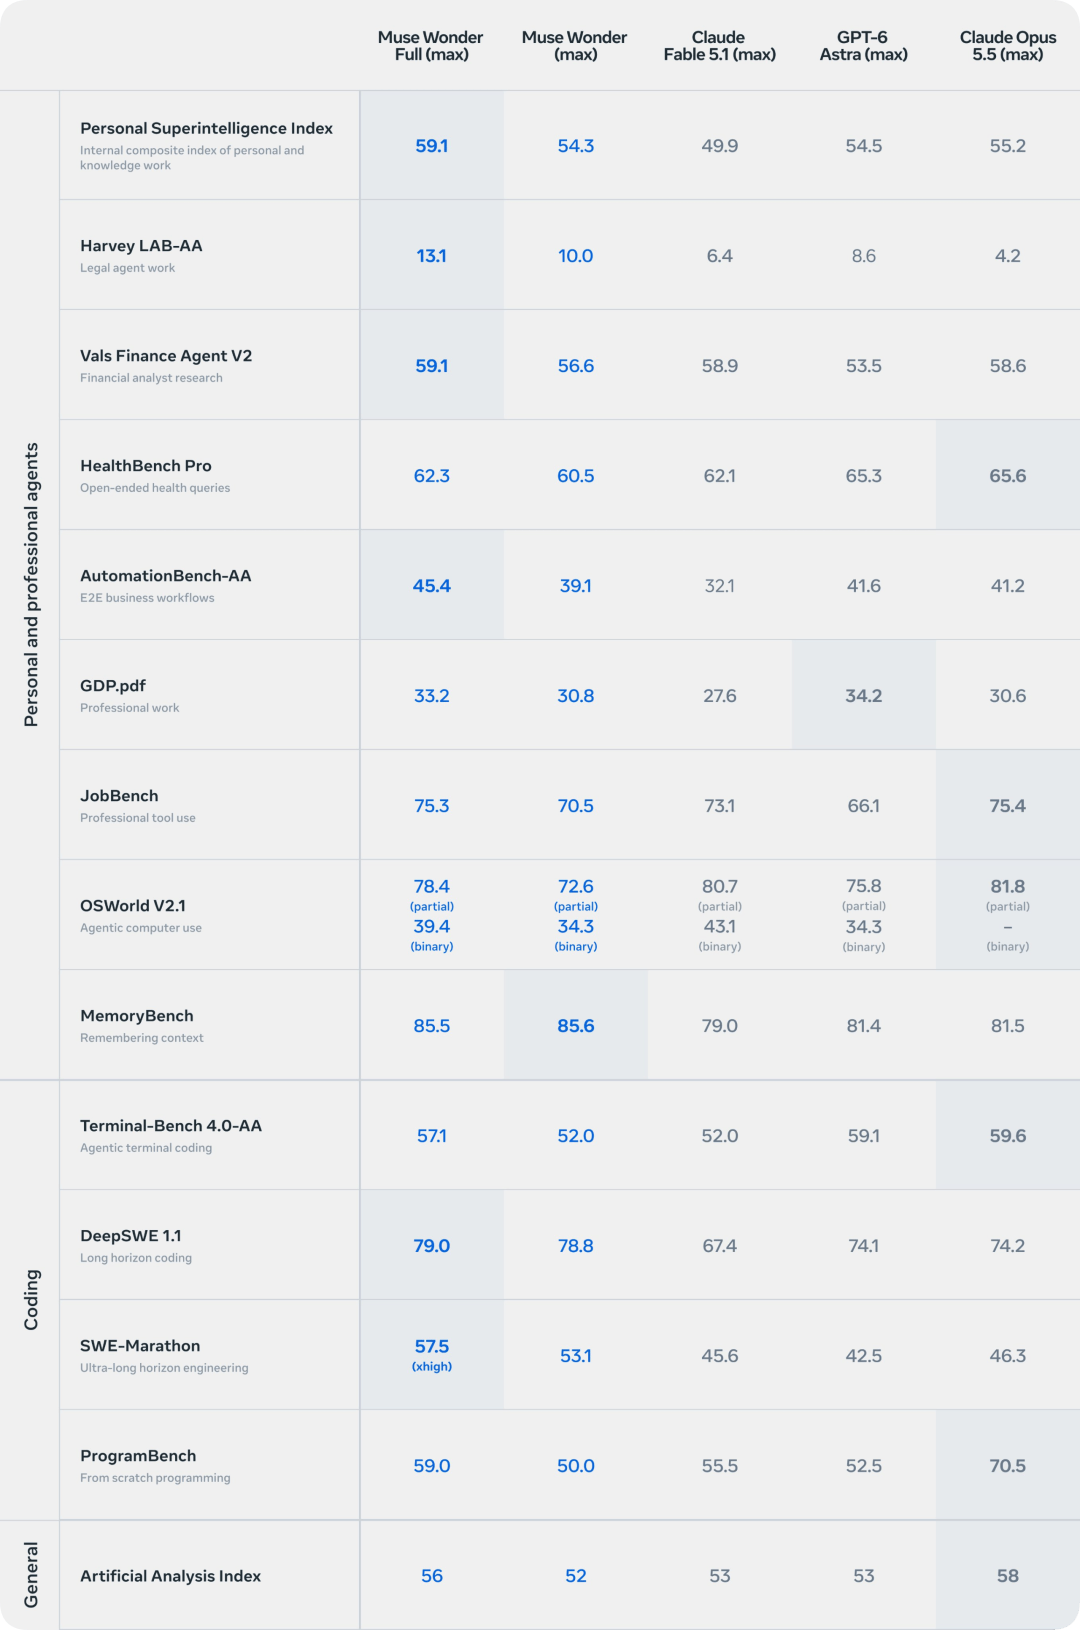
按照 Meta 公布的评测,Muse Wonder Full 新模型至少在部分基准测试上,已能与 GPT-6 Astra 和 Claude Fable 5.1 掰手腕。
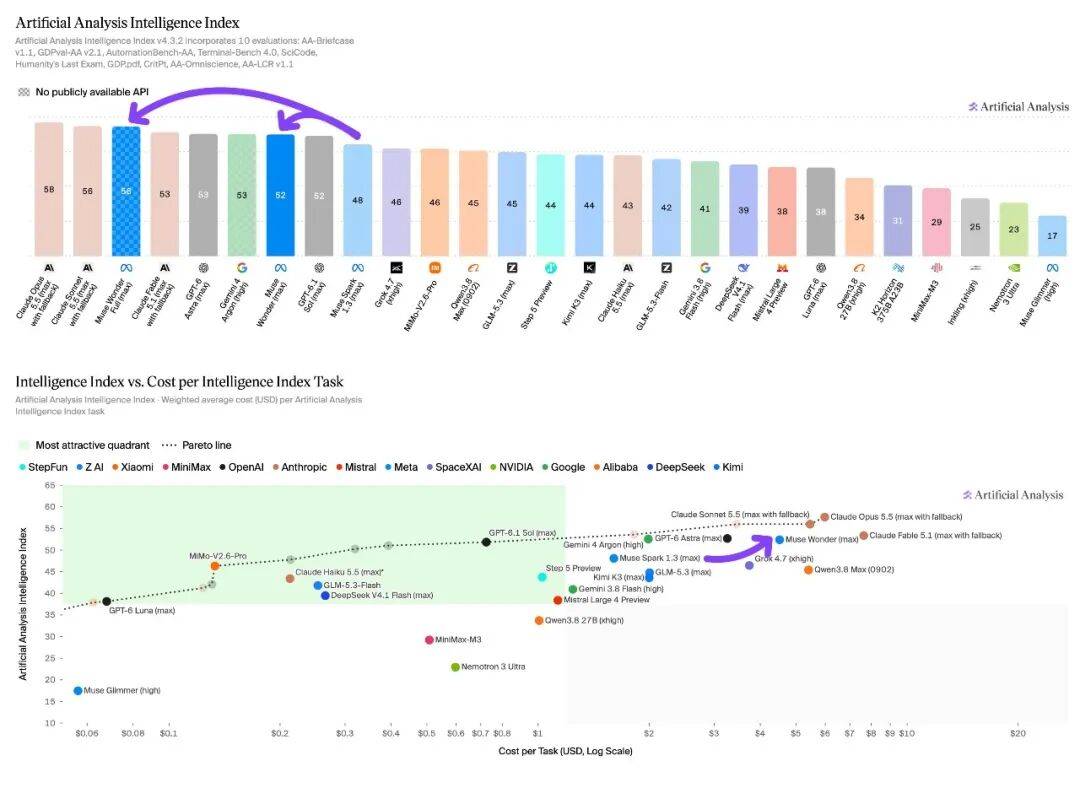
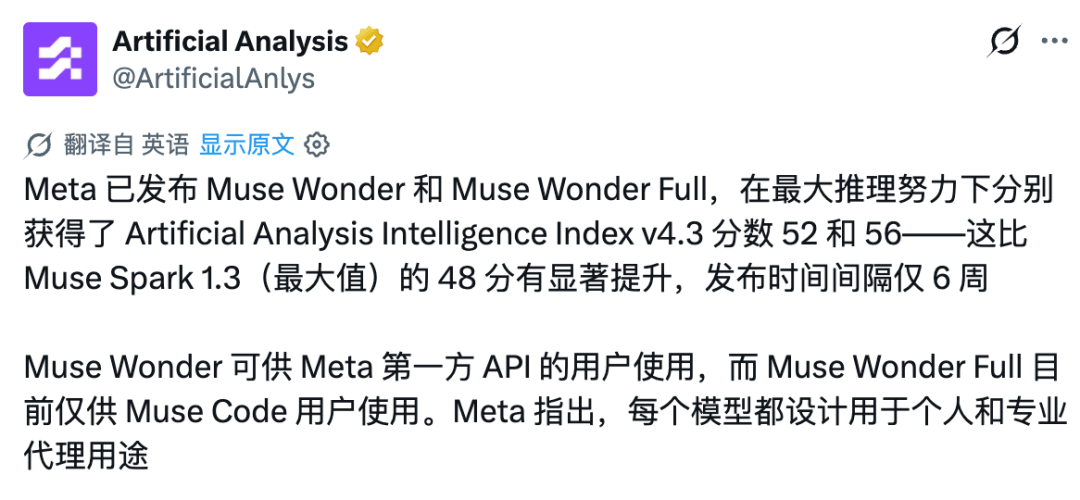
第三方机构 Artificial Analysis 的测试也显示,Wonder Full 较上一代脱胎换骨,在多项智能体和专业工作评测中跻身前三甲。
花大价钱攒起来的队伍,让 Meta 重新有了跟领先模型叫板的底气,也让 Meta Muse 的 Personal Agent 之路能走得更顺畅些。
更强的记忆和执行力,能否让 AI 善始善终
Meta 此次发布,延续了一年多来对 AI 业务的重整。
2025 年 4 月,Llama 4 马失前蹄,扎克伯格随即加大人才和算力投入,招揽 Scale AI 创始人 Alexandr Wang,重组研究团队。今年 4 月,重组后的团队推出 Muse Spark,但与竞争对手相比仍差着一口气。
按照 Meta 的说法,过去 14 个月里,团队推倒重来,从底层重建技术体系,并持续扩大预训练和强化学习的规模。 此次 Wonder 系列在吉瓦级 Prometheus 数据中心完成训练,成为这轮豪赌交出的最新筹码。
Muse Wonder 围绕两个方向动刀,分别是 Active Memory 和 Active Focus。
Active Memory 负责跨对话保留重要信息,并在新任务需要时主动找回相关内容。用户此前提过的偏好、限制和个人情况,可以成为后续任务的参考,减少每次对话都重新交代背景的麻烦。
Wang 向 Axios 表示,个人智能体需要让重要信息在数天、数周乃至数月的交流中延续下来。
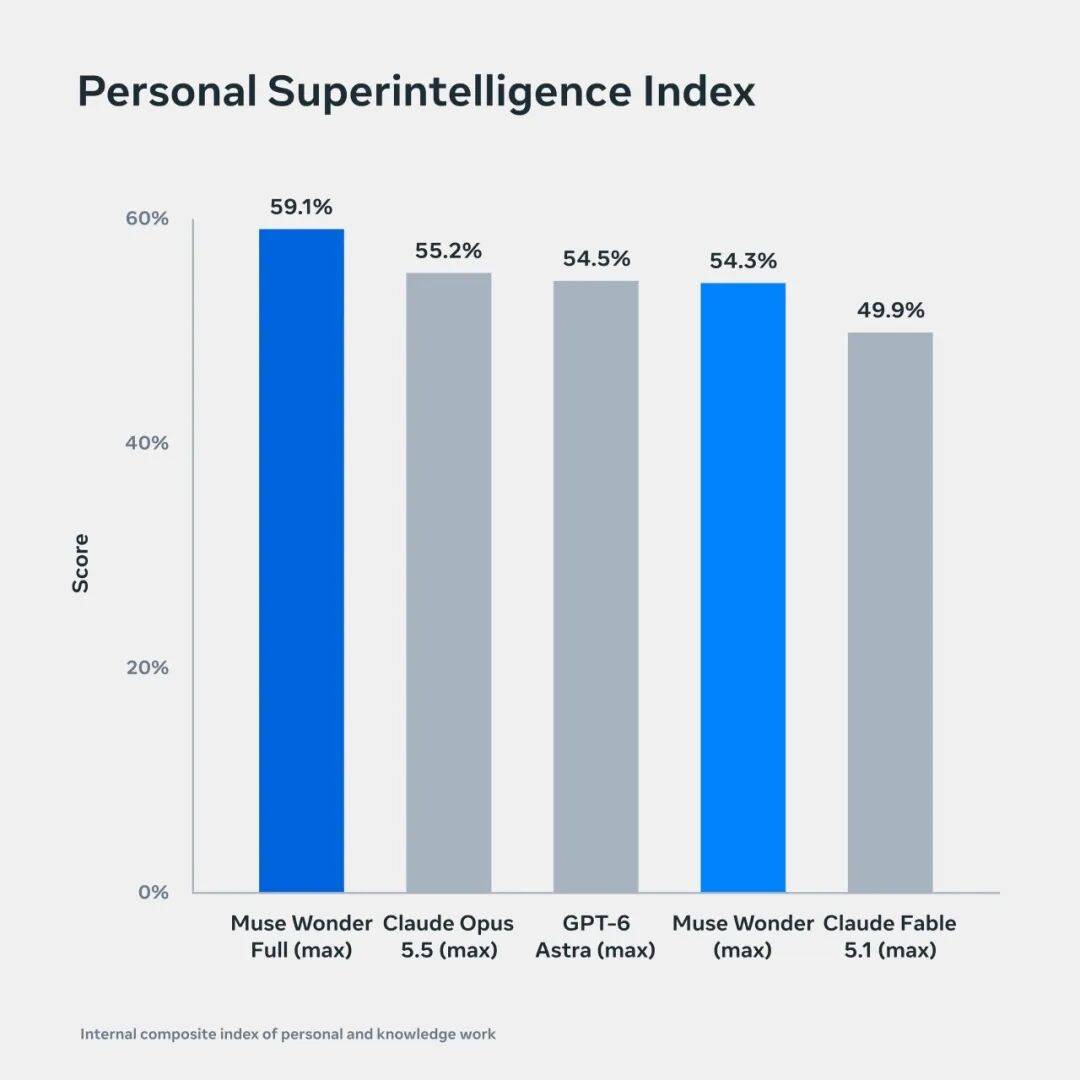

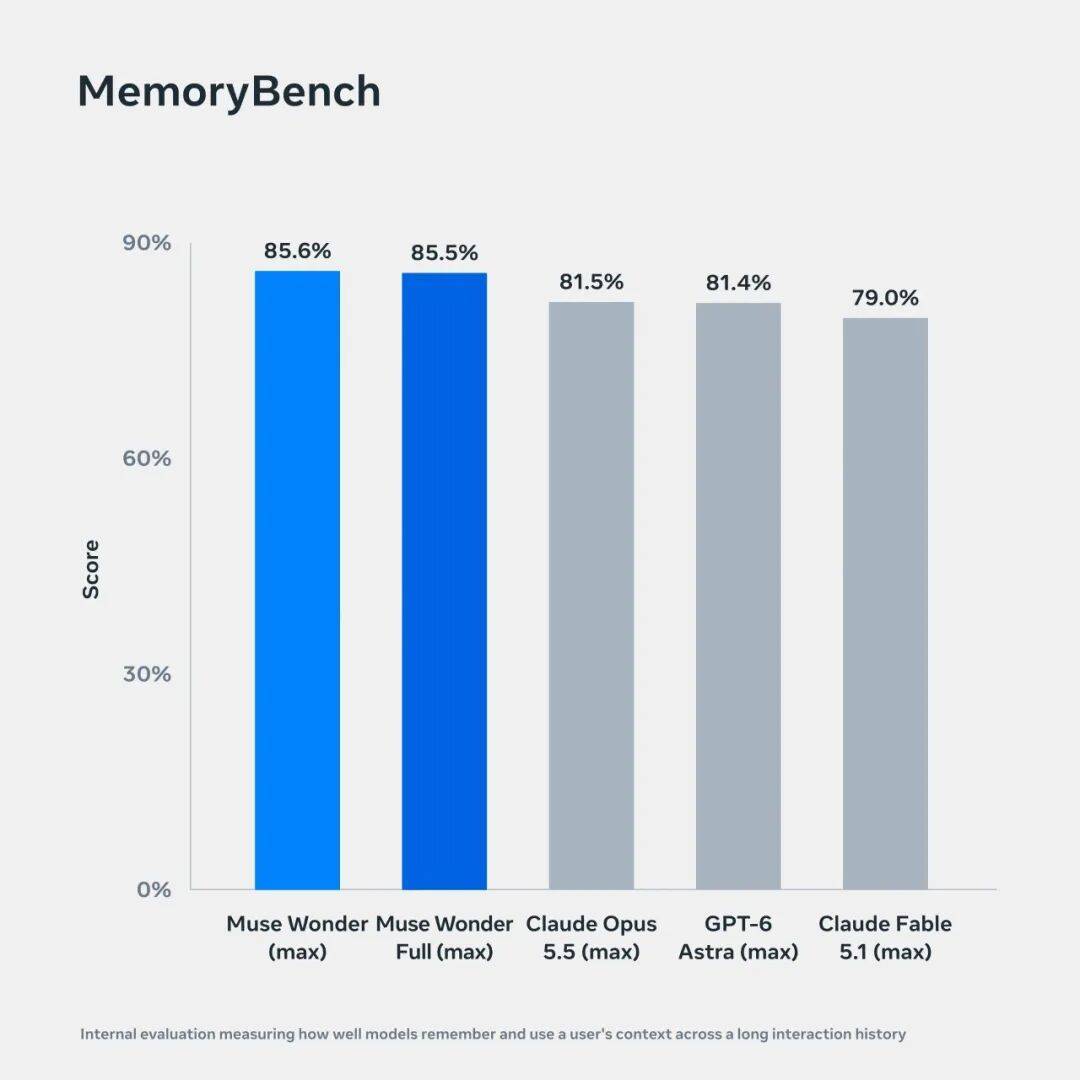
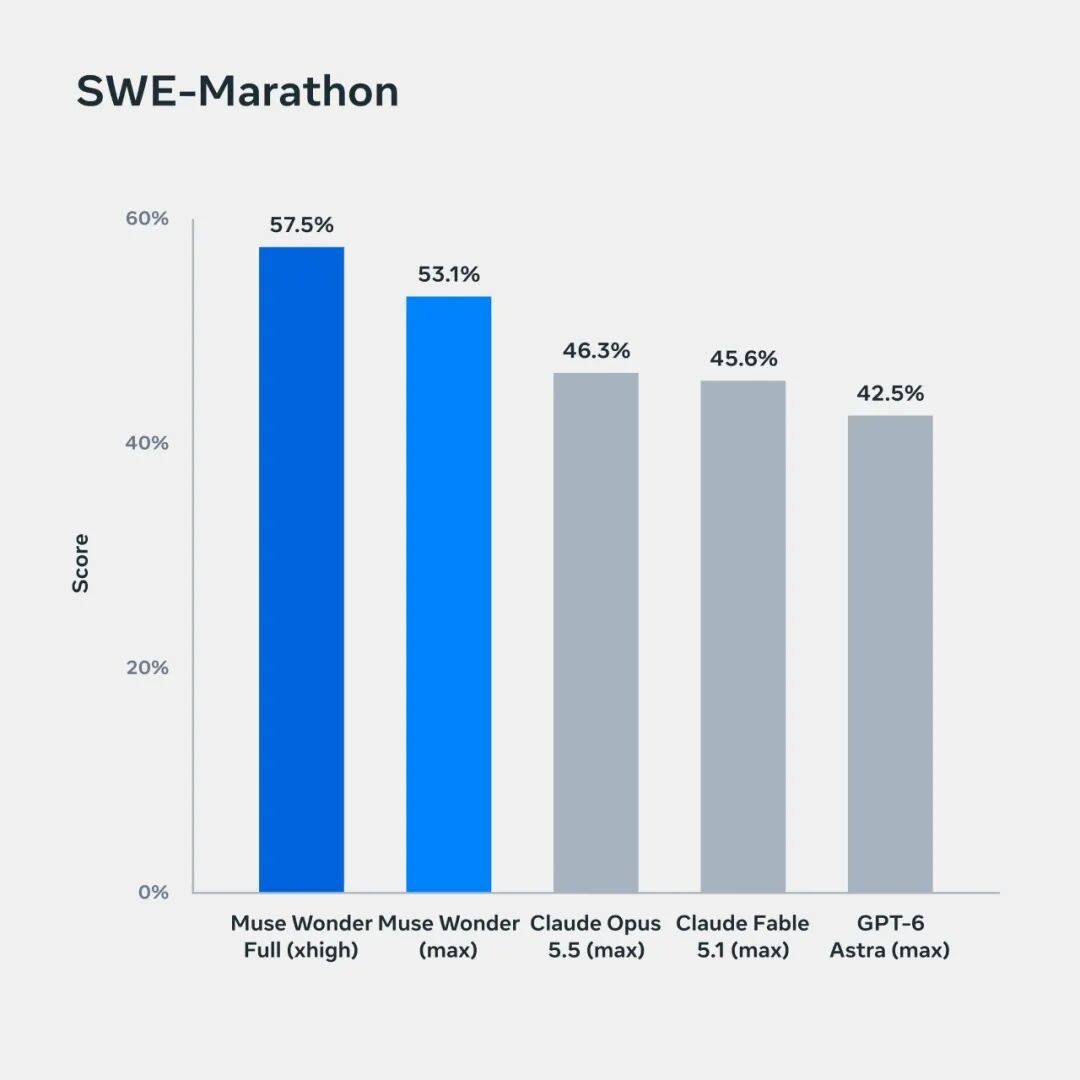
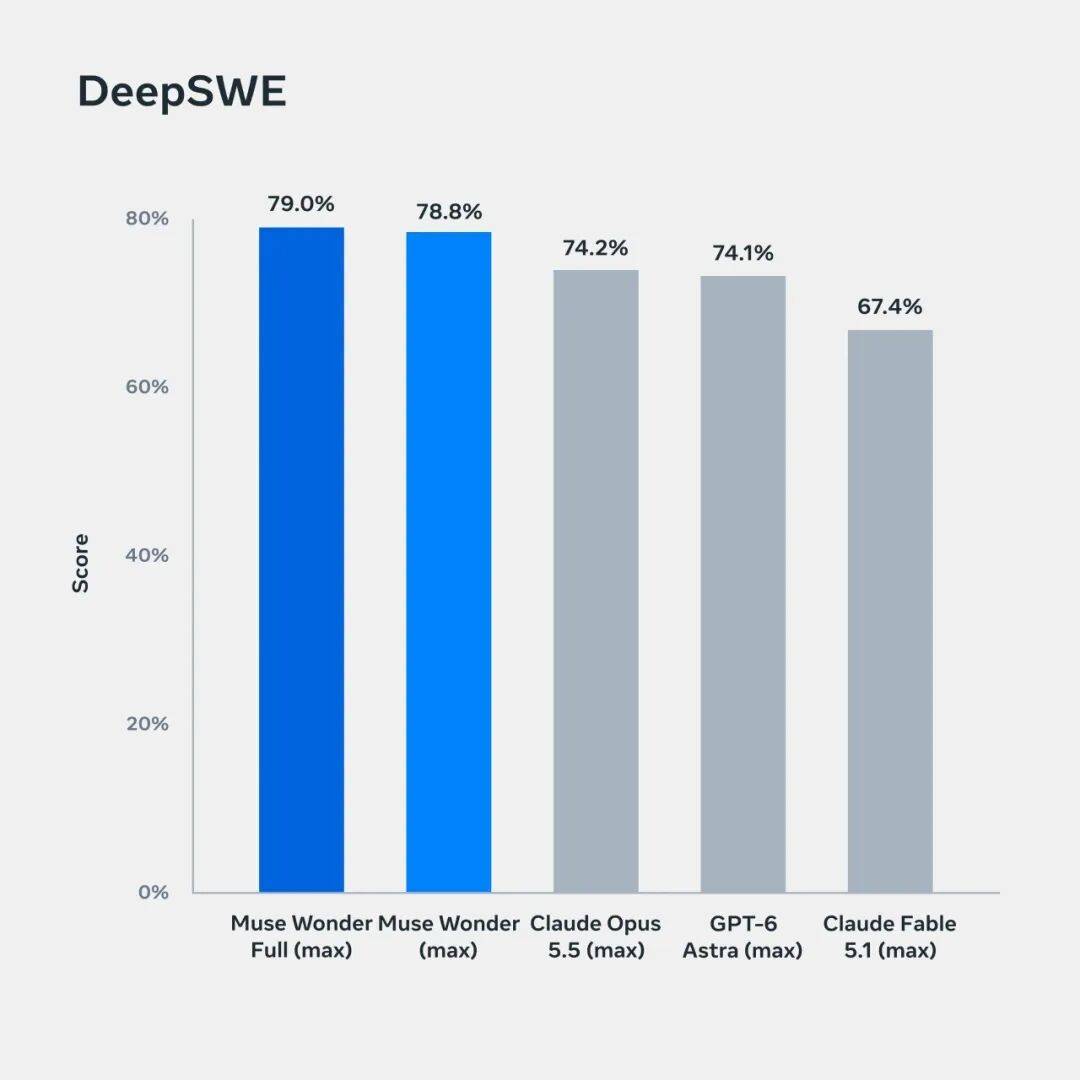
向左更多内容
Active Focus 则针对任务执行到一半停下来的问题。现实中的操作会遇到页面变化、信息缺失或预订失败,模型需要尝试其他方法,根据新信息调整计划,并持续推进任务。Meta 表示,模型仍会在必要时询问用户,并在重要操作前征求确认。
扎克伯格在最新访谈中将这一思路概括为「模型就是产品」,能力和性格等产品特征都得进训练过程。Wang 补充,智能体何时主动、如何与用户交流,也属于需要专门设计的产品行为。
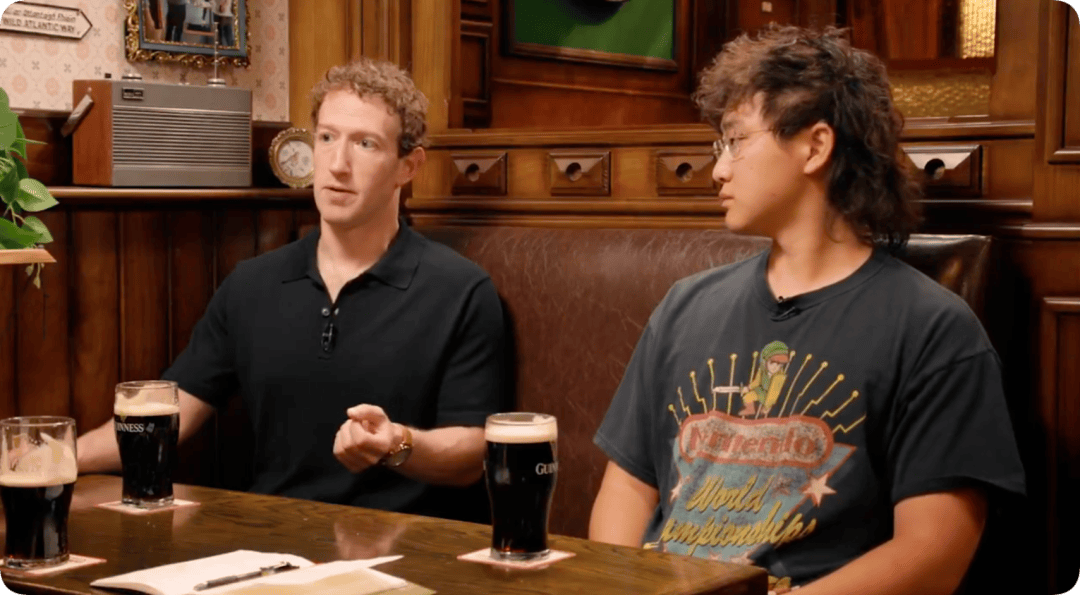
图|https://cheekypint.substack.com/p/muse-wonder-zuckerberg-and-wangs
Wang 向 CNBC 举了预订餐厅的例子。智能体查询空位时可能遭遇各种障碍,训练的目标之一,就是让它尝试其他路径,减少一遇到问题便停下来向用户求助的情况。
编程是检验这些能力的试金石。
一个持续开发的软件项目,要求模型做到心中有数:记住需求、读懂已有代码、改动多个文件、反复测试修正。Meta 表示,两款模型都接受过多种长时间任务的训练,以提高持续作战的能力。
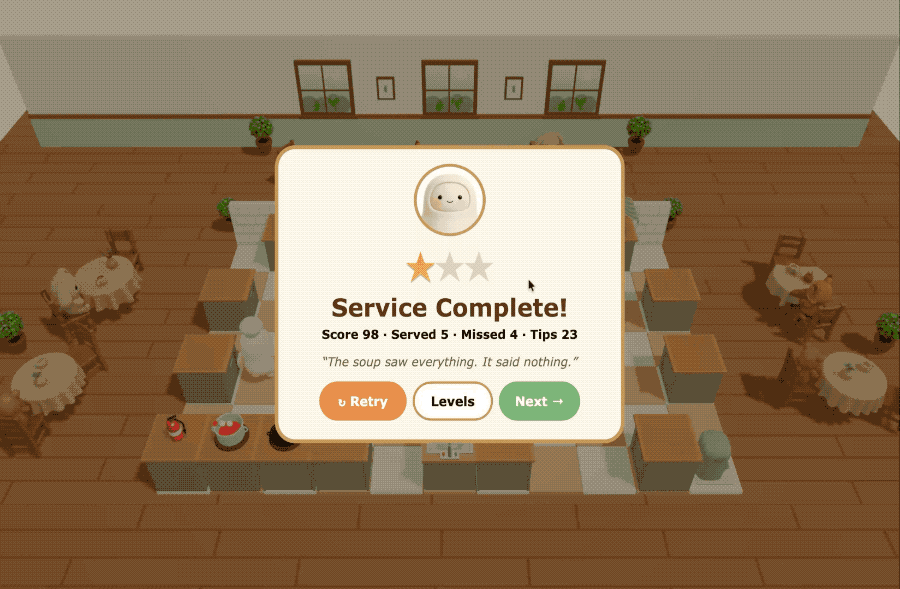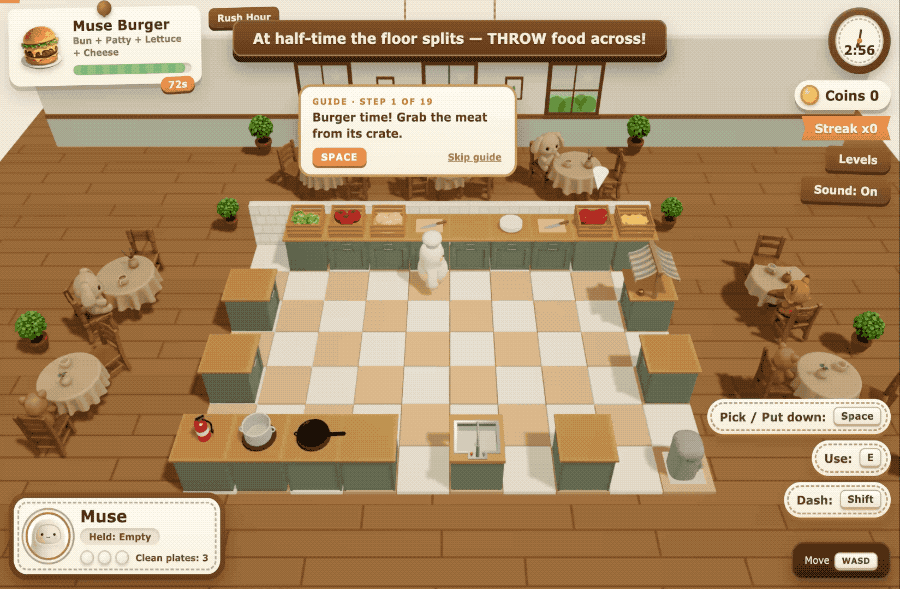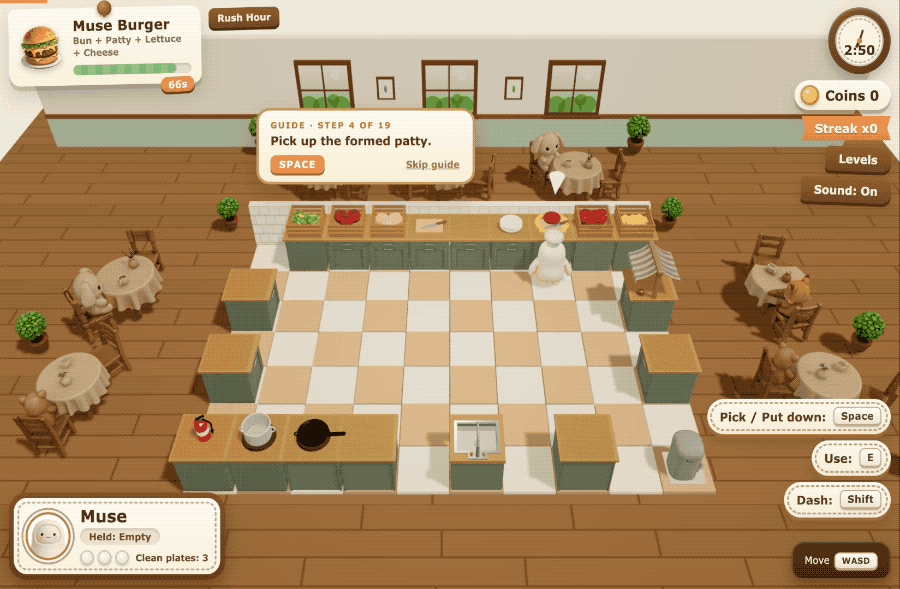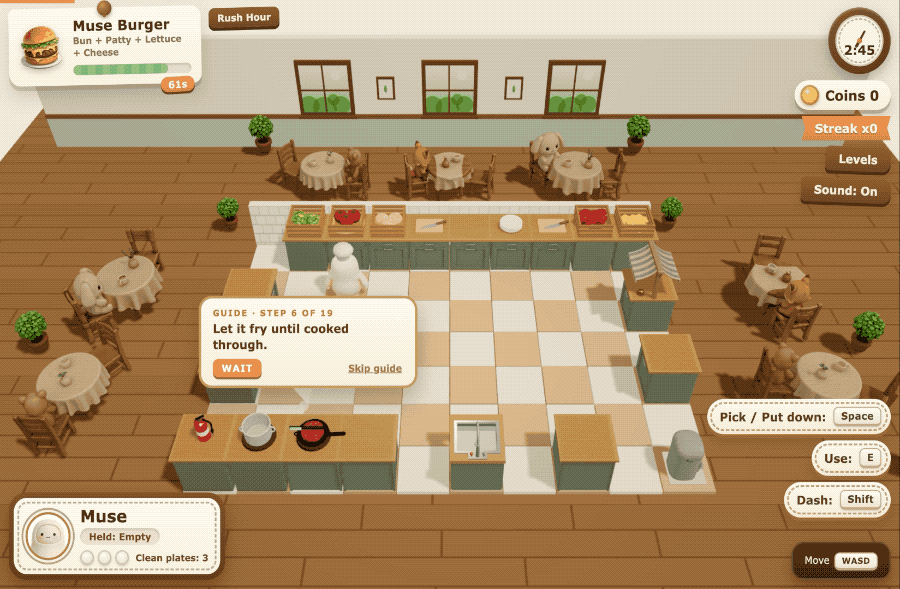
官方展示还包括「看图做菜」,根据图片生成可玩的 3D 厨房游戏,以及结合个人偏好、调动浏览器和多个应用安排跑步计划。
面向专业工作,Meta 列出了法律、金融和健康相关评测,其中 Harvey 的 Legal Agent Benchmark 要求模型依据原始材料和详细指令生成法律工作成果。

Artificial Analysis 的评测显示,Wonder 系列综合能力明显提升,Full 版十项测试有六项杀入前三。在最高推理强度下,Muse Code 搭配 Wonder Full 的编程智能体成绩与 Claude Code 搭配 Sonnet 5.5 平分秋色,还略胜搭配 Opus 5.5 一筹。
社交平台上的早期体验,则是有人欢喜有人愁。
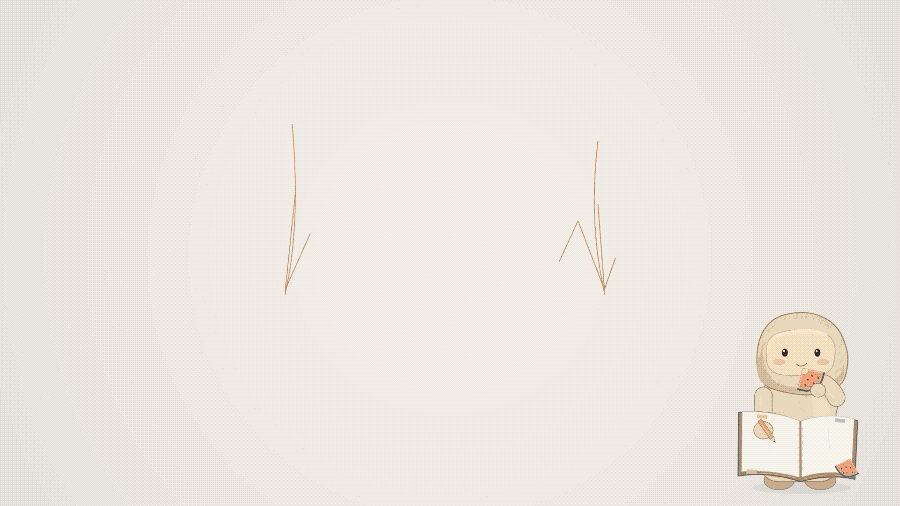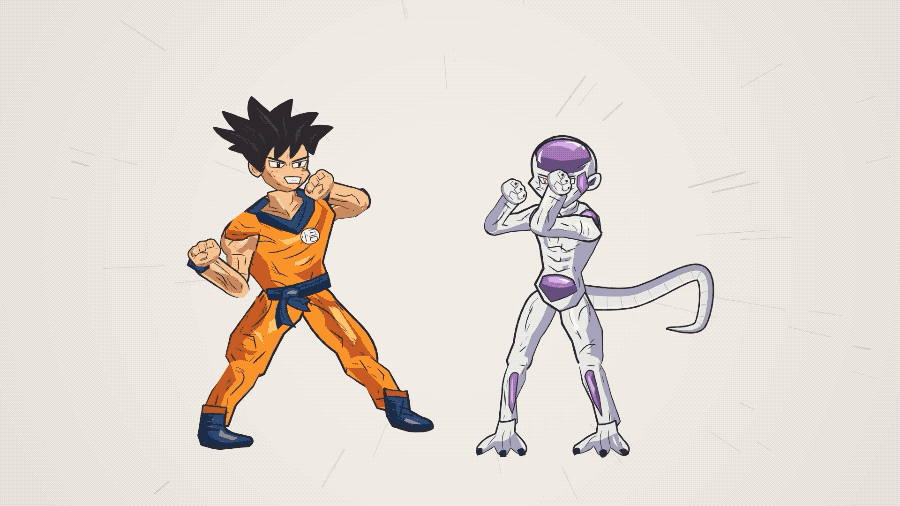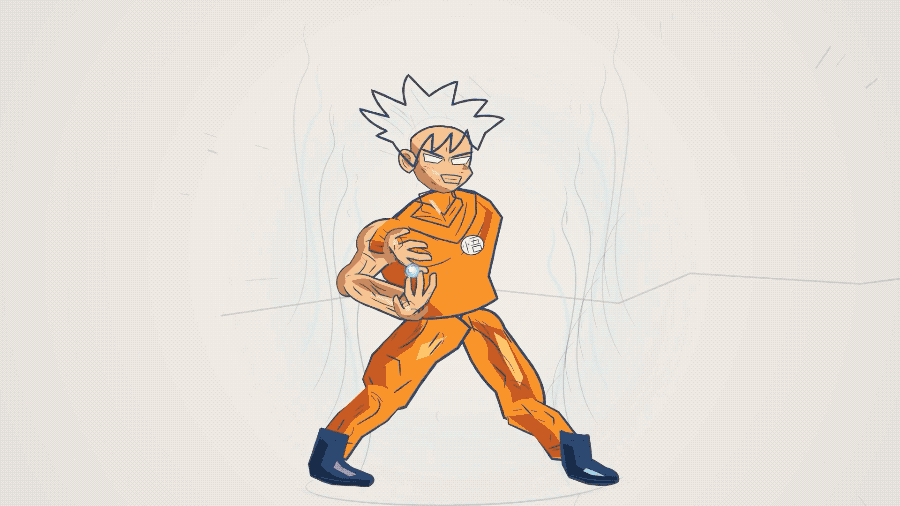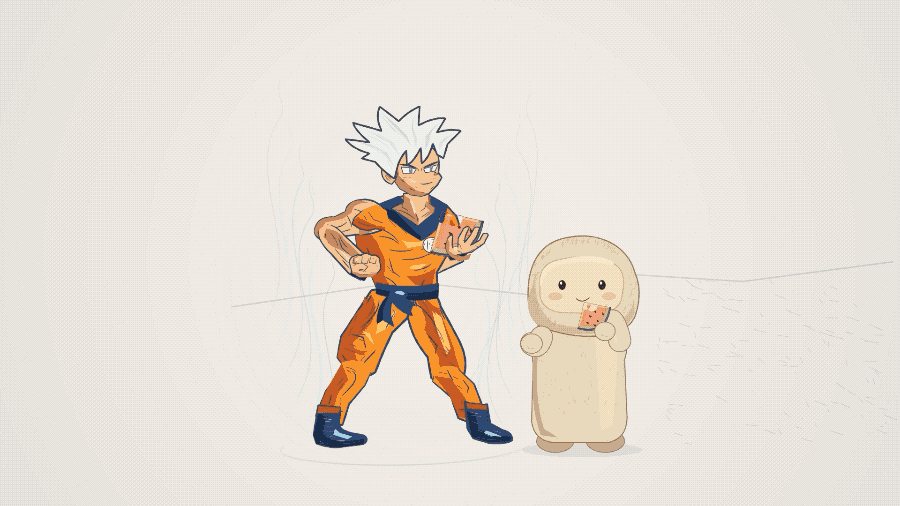
用户 Chetaslua 展示了一段包含《龙珠》角色的动画,称画面完全由代码生成,并对 Muse 的响应速度竖起大拇指。他同时注明,配音来自 ElevenLabs,音乐由 Suno 制作。

另一位用户 Max Blade 则给 Muse Wonder Full 和 Opus 5.5 出了同一道题:制作一款可以边喝啤酒、边抽雪茄的「3A 级割草机模拟器」。
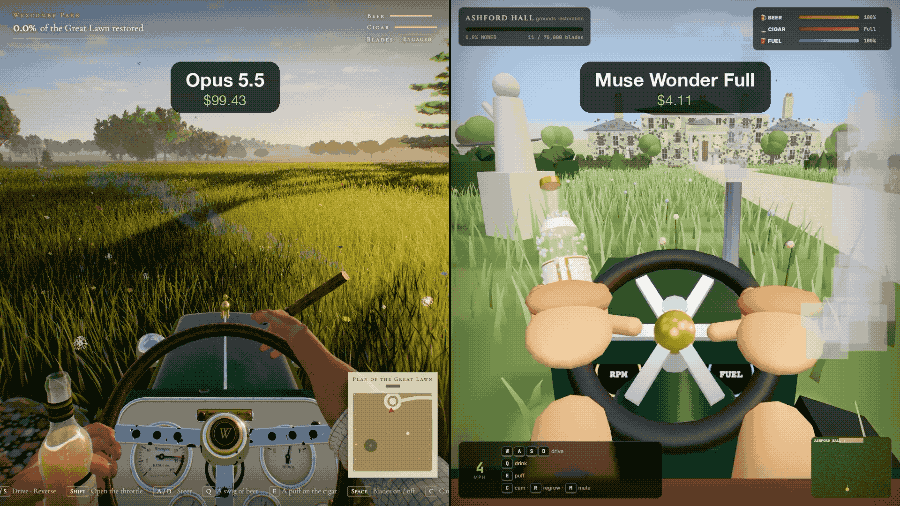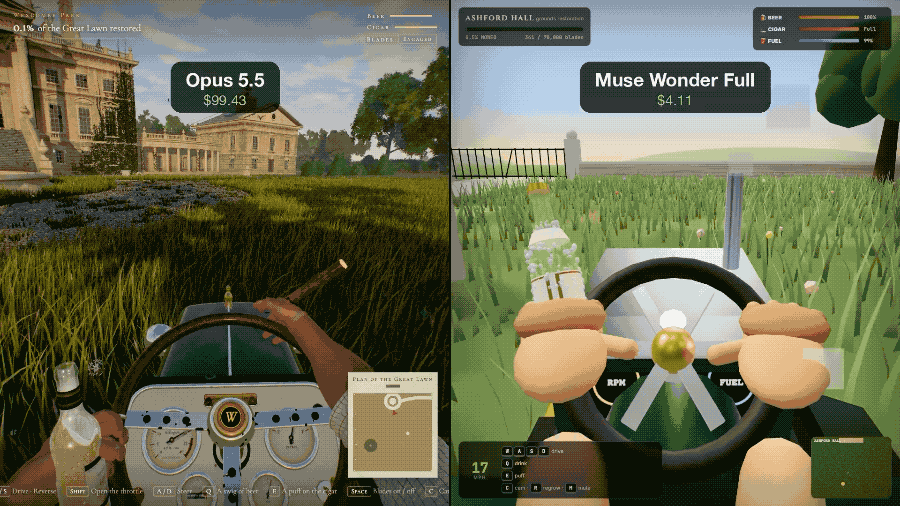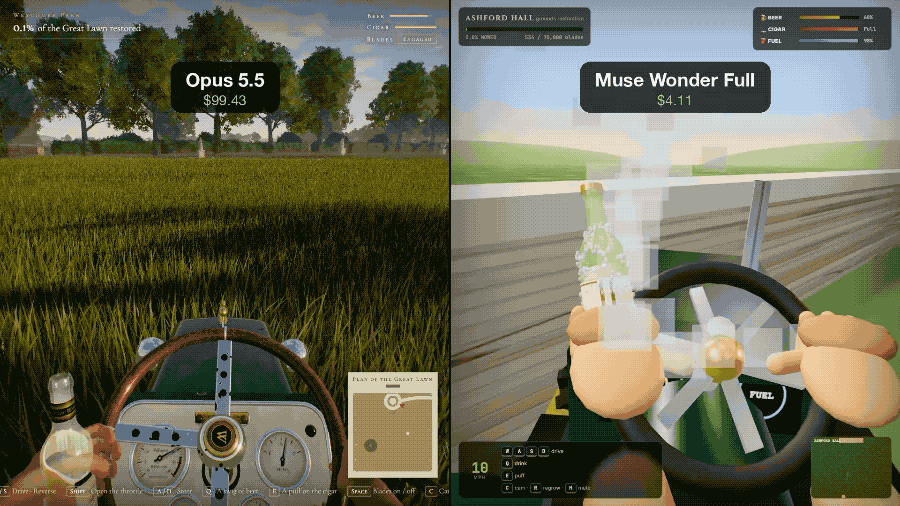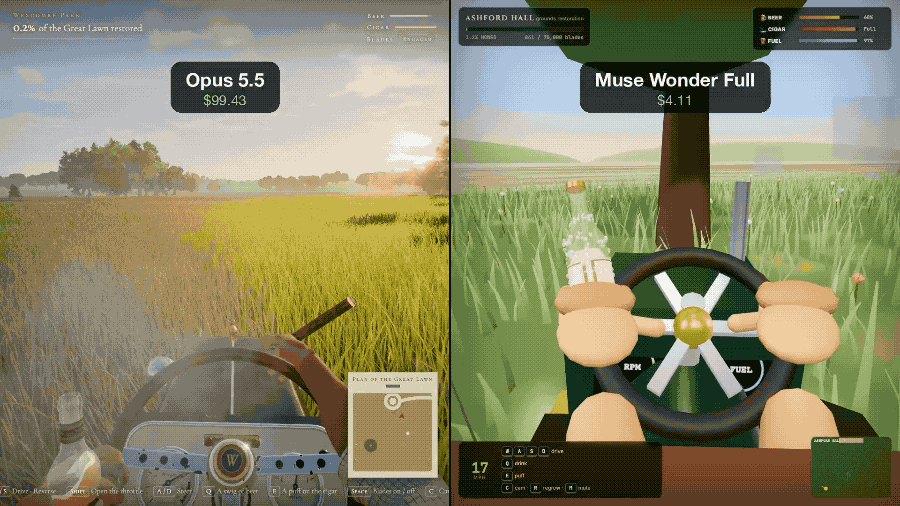
从他发布的对比画面看,Opus 版本的草地、树木和光影纤毫毕现,Muse 版本的场景与人物手部则明显粗枝大叶。他认为,Muse 在此类 3D 游戏任务上仍欠火候。
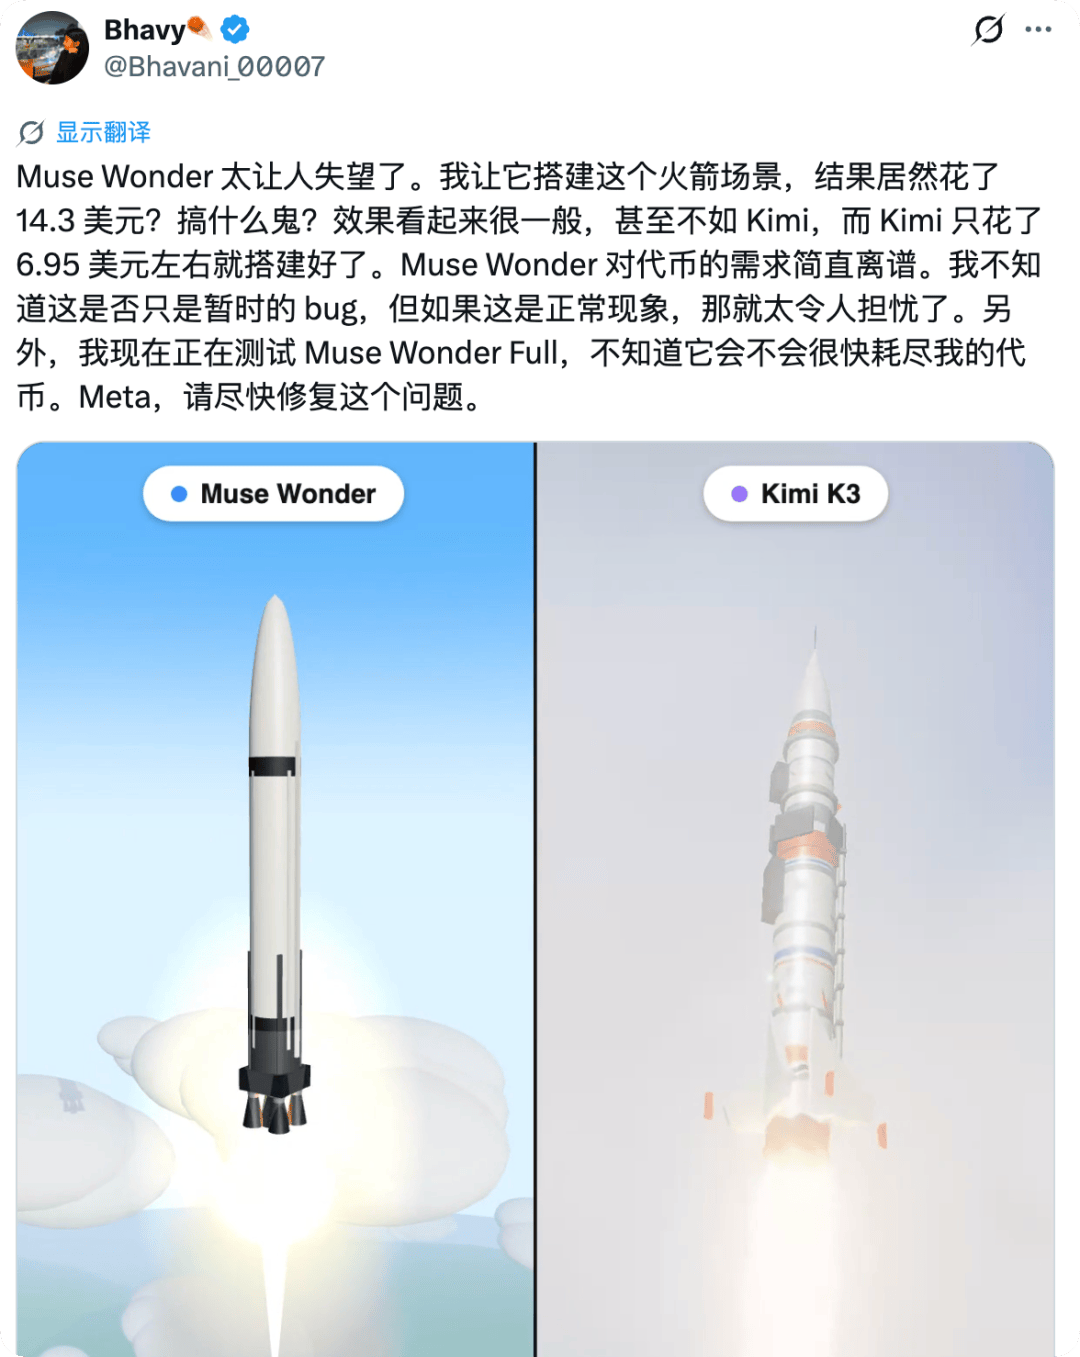
用户 Bhavy 分享的火箭场景对比也有类似反馈。他表示,Muse Wonder 的效果不如 Kimi K3,自己记录的花费却达到 14.3 美元,而 Kimi 约为 6.9 美元,堪称事倍功半。
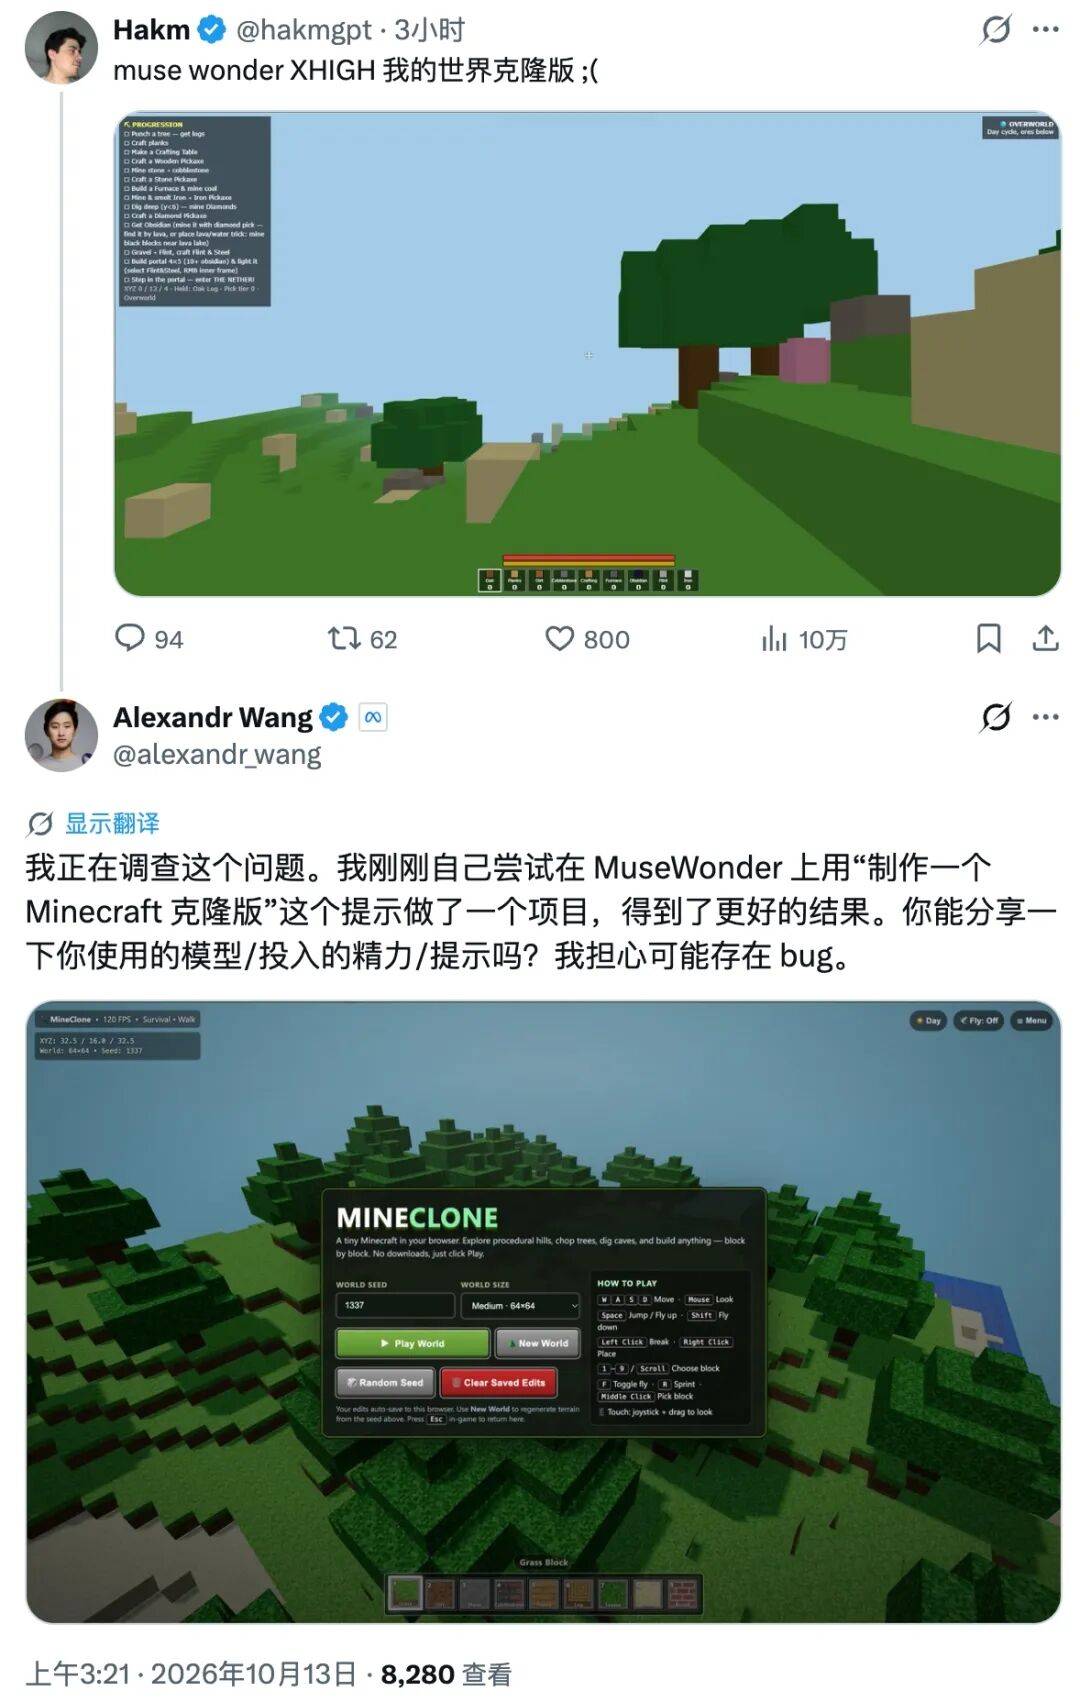
Meta AI 负责人 Alexandr Wang 在社交平台回应用户时也承认,新模型的编程能力还不如 Opus 5.5,团队正在排查多个 bug。
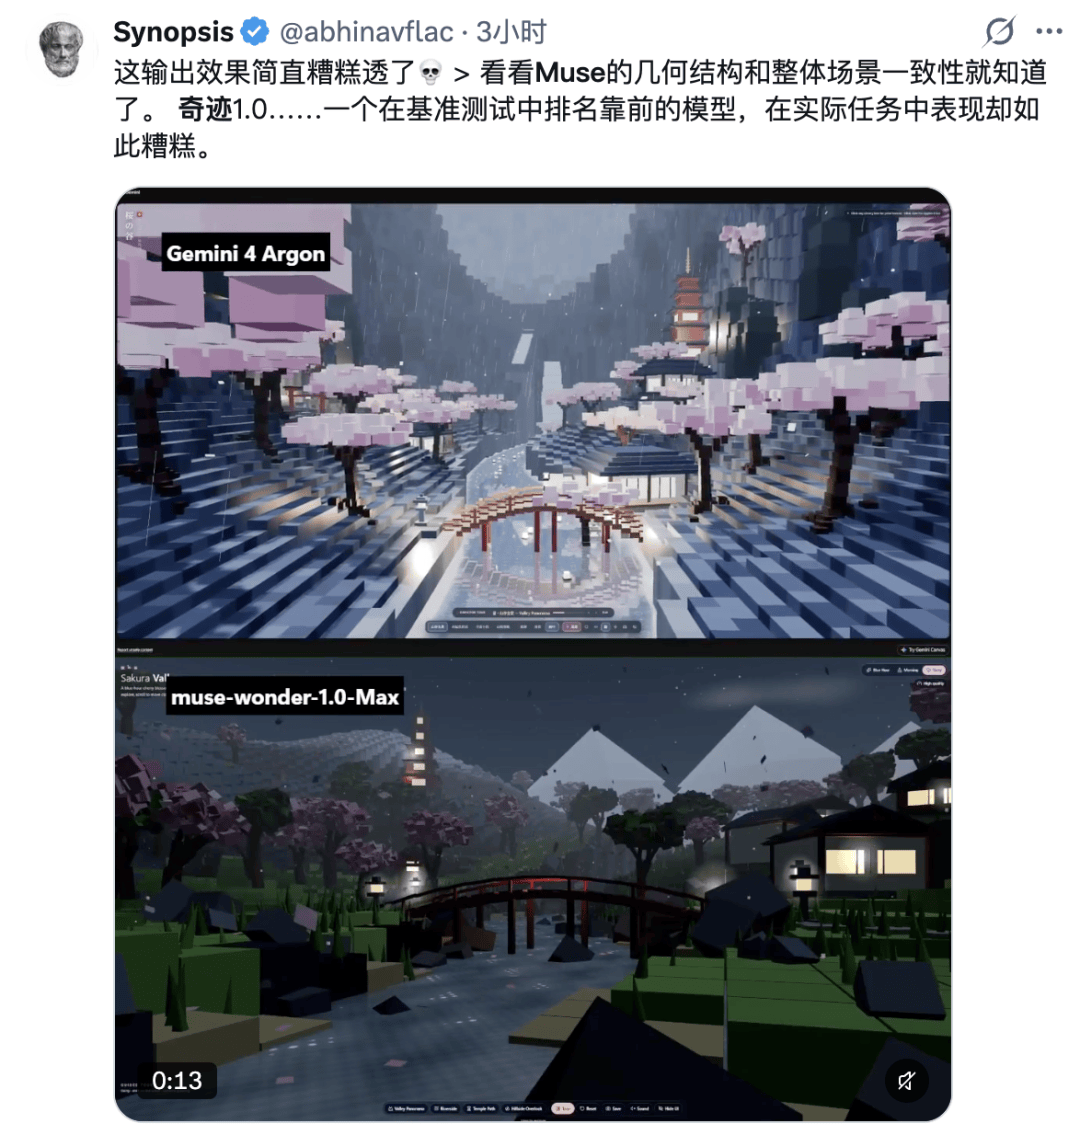

对于部分用户不满意的 3D 游戏演示效果, Wang 解释,团队没有专门针对这类演示进行训练,希望用户把模型用到真刀真枪的编程工作中。他表示,团队依据 Muse 用户的实际需求选择训练方向,同时承认可以在演示场景上多下功夫。

Meta 在官方博客中还试图回答另一个问题:模型的进步能否举一反三,迁移到训练时没有重点覆盖的任务。
团队比较了 Muse Spark 1.3 与 Muse Wonder Full 在「熟题」和「生题」上的表现。按照 Meta 的解释,随着推理计算量加码,两款模型都在进步,但 Wonder Full 在陌生任务上的表现,仍高出按 Spark 趋势推演的预期一截。
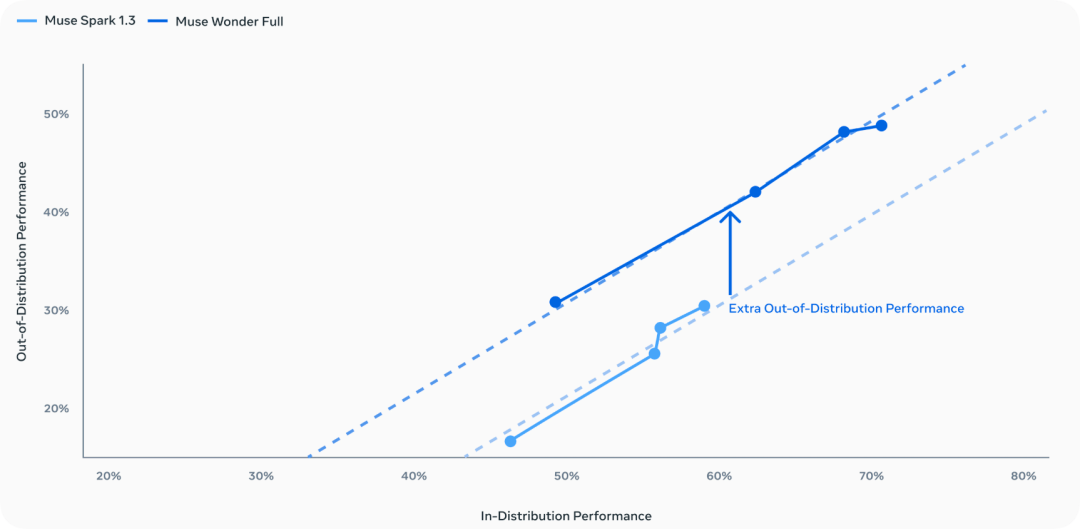
Meta 将其归因于底子厚:更大、更强的基础模型,让后训练的红利能够触类旁通。
对于需要处理不同目标、工具和限制的个人智能体,这种迁移力尤其重要。不过,这部分结论出自 Meta 的「自家答卷」,具体能覆盖哪些真实场景,还得让子弹再飞一会儿。
榜单之外,Meta 还要说服用户长期掏腰包
模型能力升级的同时,Meta 也在趁热打铁推动收费。
Muse 没有模型选择器,也没有推理强度选项。Wang 认为,普通用户不该为了用 AI 而啃技术说明书,付费升级后也不必手动挑模型,讲究一个开箱即用。
在 API 方面,Muse Wonder 价格为每百万输入 token 4 美元、每百万缓存输入 token 0.20 美元,以及每百万输出 token 20 美元。两款模型均支持 100 万 token 上下文,可接收文本、图像、视频和音频输入,输出形式为文本。
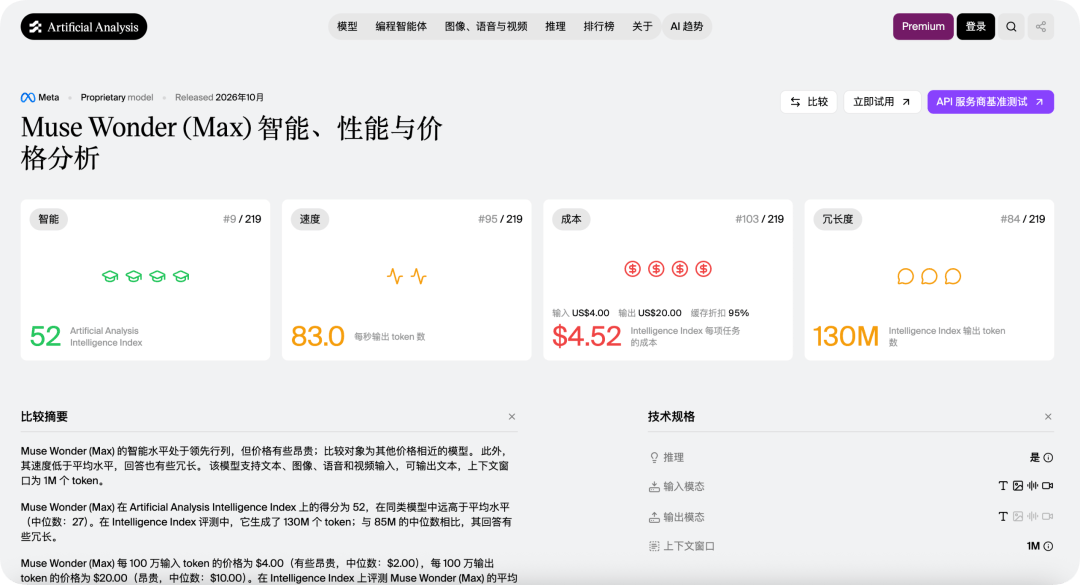
而按照 Artificial Analysis 的 Intelligence Index 测试,Muse Wonder 在最高推理强度下,每项任务成本约为 4.52 美元,低于同次比较中的 Claude Fable 5.1、Opus 5.5 和 Sonnet 5.5,却高于 GPT-6 Astra 的 3.26 美元、Gemini 4 Argon 的 1.99 美元,以及 GPT-6.1 Sol 的 0.72 美元。
Artificial Analysis 指出,Wonder 虽然比上一代省输出 token,但较高的输入消耗与 API 定价仍然推高了总账。用户最终要算的,还包括完成同一项工作要烧多少 token,以及中途要返工几次。
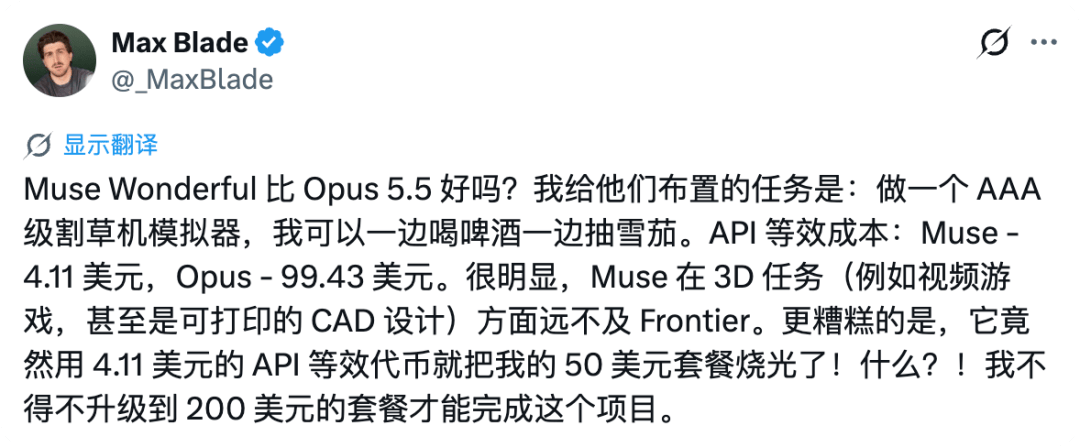
在前述割草机模拟器测试中,Max Blade 为 Muse Wonder Full 和 Opus 5.5 标注的「API 等效成本」分别为 4.11 美元和 99.43 美元,但他称,Muse 胃口太大,已耗尽自己 50 美元套餐的可用额度,迫使他升级到 200 美元套餐才跑完任务。
当然,作为开源模型的老大哥,此次发布也让 Meta 的「开源人设」再次受到审视。尽管 Muse Wonder 采取闭源模式,但 Wang 表示 Meta 初心不改,仍然支持开源,并提到此前已开放 Muse Glimmer 的权重,以及将 Muse 智能体部署到硬件上的相关技术。
但智能体能否长成摇钱树,还取决于模型之外的变量。
最近,一些用户在社交平台投诉 Muse 未经授权访问个人消息,Meta 对此则提出异议,称部分情况可能是用户在较早的对话中授过权,转头忘了;团队正在跟踪这些问题,并帮助用户弄清授权是如何生效的。
双方各执一词,但 Personal Agent 的产品设计必须面对一个现实:用户可能在很久之前点过头,模型却会在后续任务中拿旧账当令箭,授权范围和有效时间因此需要一目了然。
Meta 表示,Wonder 系列加强了抵御恶意指令、处理私人信息,以及防范网络和生物领域滥用的能力,后续还将发布更完整的安全报告。
扎克伯格则提到尚未推出的 Muse Confidential VM,称该方案计划让用户数据和与智能体的对话对 Meta 自身也密不透风。
有趣的是,在接受《金融时报》采访时, 扎克伯格拒绝了给 AI 发展「踩刹车」的主张,认为各家实验室应通过技术措施和负责任的开发来保障安全。他还透露,Meta 已在研发下一阶段的模型,并预计之后的进展会更快。
持续提升的模型能力,最终还是要支撑起扎克伯格设想中的 Personal Agent,让 AI 能够处理个人日常事务。用最前沿的技术订餐、安排行程、处理邮件,听起来有些大材小用,但这些任务都要面对不断变化的信息和各不相同的个人要求。
Muse Wonder 选择的方向,也让模型进步有了更具体的衡量方式。AI 的能力可以由最难的题目来检验, 个人智能体的价值,则要由那些每天重复、又总得有人操心的小事来证明。
本文来自转载APPSO ,观点仅代表作者本人,发现AI平台仅提供信息存储空间服务。
如若转载,请联系原作者;如有侵权,请联系编辑删除。

 微信扫一扫